Infozense Knowledge Engineering

คลังความรู้ของคุณกับฐานข้อมูลของคุณไม่เคยมาเจอกัน นี่คือเหตุผลที่ต้องมี Knowledge Engineering

คุณมีฐานข้อมูลที่เต็มไปด้วยแถวข้อมูล และคลังความรู้ที่เต็มไปด้วยเอกสาร ไฟล์ PDF ไฟล์ Flat และทุกอย่างที่ไม่เคยมีใคร Query ได้ ทั้งสองอย่างเต็มไปด้วยสิ่งที่องค์กรของคุณรู้ แต่ไม่เคยมีใครอ่านทั้งสองอย่างพร้อมกัน คนจึงยังต้องเปิดสองระบบ แล้ว Join มันเข้าด้วยกันในหัวตัวเอง ทำไมถึงเป็นแบบนั้น? เพราะการรวมสองอย่างนี้อย่างปลอดภัยไม่ใช่ปัญหาเรื่องการต่อท่อ ข้อมูลสองด้านนี้มีระดับความอ่อนไหวมาด้วยกลไกที่ต่างกันโดยสิ้นเชิง Governance จึงต้องครอบไปถึงจุดที่มันมาบรรจบกัน Knowledge Engineering คือเลเยอร์ที่การรวมนั้นเกิดขึ้นและยังคงถูกกำกับอยู่

Infozense Knowledge Engineering · CIO · Head of Data · CISO · ~7 นาที

ชุดบทความ Infozense Knowledge Engineering อธิบายเลเยอร์ข้อมูลที่มี Governance เลเยอร์นั้นมี Gate อยู่ห้าตัว: Input (ใครมีสิทธิ์ถาม) · Egress (อะไรออกไปได้) · Output (ปลอดภัยและเป็นจริง) · Action (ใครอนุมัติ) · Operational (พิสูจน์ได้ภายหลัง) บทความนี้ว่าด้วยสิ่งที่ Gate เหล่านั้นกำกับอยู่ แต่เป็นสิ่งนั้นเอง

ลองถามคำถามจริงกับองค์กรของคุณ แล้วดูว่าคำตอบถูกประกอบขึ้นมาอย่างไร

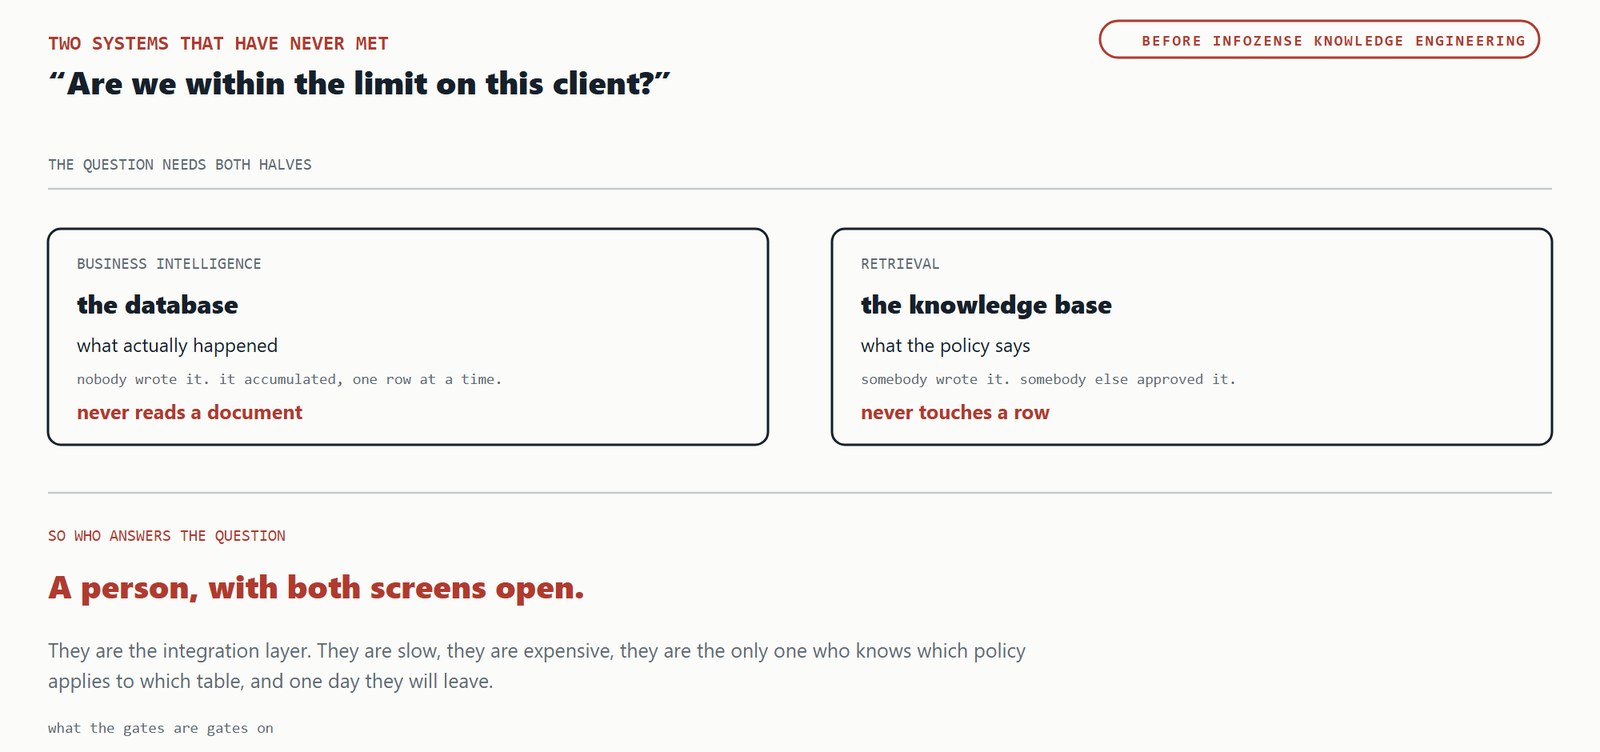
เรายังอยู่ในวงเงินของลูกค้ารายนี้หรือเปล่า? วงเงินนั้นอยู่ในเอกสาร มีคนเขียนมันขึ้นมา ผ่านการอนุมัติ และอยู่ในนโยบายที่ทีม Compliance ของคุณดูแล ส่วนยอดปัจจุบันอยู่ในฐานข้อมูล ไม่มีใครเขียนมันขึ้นมา มันสะสมขึ้นมาเองทีละรายการ และมันเปลี่ยนไปแล้วระหว่างที่คุณอ่านประโยคนี้

ไม่มีระบบไหนตอบคำถามนี้ได้ คนต่างหากที่เป็นคนตอบ โดยเปิดทั้งสองระบบขึ้นมา แล้ว Join มันเข้าด้วยกันในหัวตัวเอง

คนคนนั้นคือ Integration Layer ช้า มีต้นทุนสูง เป็นคนเดียวที่รู้ว่านโยบายข้อไหนใช้กับตารางไหน และวันหนึ่งคนคนนั้นก็จะลาออกไป พร้อมกับทักษะที่เกิดจากประสบการณ์การทำงาน

เมื่อยังไม่มี Infozense Knowledge Engineering สองระบบที่ไม่เคยมาเจอกัน ฐานข้อมูลเก็บสิ่งที่เกิดขึ้นจริงและไม่เคยอ่านเอกสาร คลังความรู้เก็บสิ่งที่นโยบายเขียนไว้และไม่เคยแตะแถวข้อมูล คนที่เปิดทั้งสองจอพร้อมกันคือ Integration Layer
คำถามนี้ต้องใช้ทั้งสองด้าน แต่ไม่เคยมีระบบไหนมีครบทั้งสองด้าน

บทความนี้เขียนถึงใคร

ถ้าคำถามของคุณตอบได้จากเอกสารเพียงอย่างเดียว เรื่องนี้ไม่ใช่ปัญหาของคุณ ระบบ Retrieval บนคลังเอกสารที่ดีคือเครื่องมือที่ถูกต้องแล้ว และคุณก็มีมันอยู่แล้ว

คุณจะเจอปัญหานี้เมื่อคำถามต้องใช้ทั้งสองด้าน เคลมนี้เบิกได้ไหม ต้องใช้ทั้งกติกาการลงรหัสและข้อมูลการเข้ารับบริการ อนุมัติรายนี้ได้หรือเปล่า ต้องใช้ทั้งนโยบายสินเชื่อและยอดคงค้าง ซัพพลายเออร์รายนั้นผิดสัญญาหรือไม่ ต้องใช้ทั้งตัวสัญญาและประวัติการส่งมอบ ทุกกรณี เอกสารเป็นตัวให้กติกา และฐานข้อมูลเป็นตัวให้ข้อเท็จจริง ส่วนคำตอบคือจุดที่สองอย่างนี้มาชนกัน

ปัญหายิ่งหนักขึ้นไปอีกถ้ากติกานั้นอยู่ใต้การกำกับดูแล หรือข้อเท็จจริงนั้นเป็นข้อมูลส่วนบุคคล หรือทั้งสองอย่าง ซึ่งในธุรกิจที่ถามคำถามแบบนี้ ส่วนใหญ่ก็คือทั้งสองอย่าง

เราแก้ปัญหานี้ไปแล้วครึ่งเดียว สองครั้ง

Business Intelligence แก้ไปได้ครึ่งหนึ่ง และแก้ได้ดีด้วย คุณเอาเครื่องมือไปจ่อที่ฐานข้อมูล แล้วถามได้เสียทีว่าเกิดอะไรขึ้น กี่ครั้ง เท่าไร ภูมิภาคไหน ตั้งแต่เมื่อไร องค์กรส่วนใหญ่ยังเดินอยู่บนสิ่งนี้ และยังทำอยู่ต่อไป เนื่องจากทางเลือกไม่ได้มีมากนัก ที่แย่กว่านั้นคือมันไม่สามารถเข้าใจข้อความในเอกสาร มันบอกได้ว่าใช้เงินไปเท่าไร แต่บอกไม่ได้ว่านโยบายยอมให้ใช้หรือไม่

ระบบ Retrieval แก้อีกครึ่งหนึ่ง เอาโมเดลไปจ่อที่คลังเอกสาร ถามด้วยภาษาคนว่านโยบายเขียนไว้ว่าอย่างไร แล้วได้คำตอบพร้อมแหล่งอ้างอิง อันนี้ก็ของจริง ใช้งานกันแพร่หลาย แต่มันไม่เคยแตะแถวข้อมูลสักแถว มันตอบจากสิ่งที่ถูกเขียนไว้ ไม่เคยตอบจากสิ่งที่เกิดขึ้นจริง

คุณจึงมีระบบที่เก่งอยู่สองระบบซึ่งไม่เคยมาเจอกัน กับคนหนึ่งคนตรงกลาง ที่ถือวิธีเชื่อมสองระบบนั้นเข้าด้วยกันไว้เป็นสำเนาเดียวที่ใช้งานได้จริง

ข้อมูลสองด้านนี้เป็นคนละชนิดกัน

ไม่ใช่ว่าไม่มีใครนึกถึงเรื่องนี้ สองระบบนี้ไม่เคยมาเจอกัน ด้วยเหตุผลเดียวกับที่ทำให้การรวมมันเข้าด้วยกันอย่างปลอดภัยเป็นเรื่องยาก

คลังความรู้กับฐานข้อมูลเป็นของคนละชนิดกัน อย่างแรกเก็บข้อความที่คนหนึ่งเขียนและอีกคนอนุมัติ ความหมายของมันอยู่ในตัวข้อความ และระดับความอ่อนไหวถูกตัดสินโดยคนที่กำหนด Classification ให้เอกสารนั้น ส่วนอย่างที่สองเก็บแถวข้อมูลที่ไม่มีใครเขียน ความหมายของมันอยู่ในโครงสร้างตาราง และระดับความอ่อนไหวขึ้นอยู่กับว่าคุณไปแตะคอลัมน์ไหนมาบ้างเท่านั้น

ระบบที่อ่านทั้งสองอย่างจึงไม่ได้กำลังอ่านแหล่งข้อมูลสองแหล่ง แต่กำลังอ่านนิยามของคำว่า “ข้อมูล” สองแบบที่ต่างกัน และมันต้องแบก Governance ของทั้งสองแบบไว้พร้อมกัน

การเอาฐานข้อมูลไปต่อพ่วงกับระบบ Retrieval ไม่ได้ทำสิ่งนั้น มันแค่ให้แหล่งข้อมูลที่สองกับ AI โดยไม่ได้ให้วิธีคิดว่าแหล่งที่สองนั้นได้รับอนุญาตให้ถูกใช้ทำอะไรได้บ้าง ผลที่มักตามมาคือระบบยอมเอาแถวข้อมูลซึ่งอยู่ใต้การกำกับดูแล กับย่อหน้าที่เป็นข้อมูลสาธารณะ ใส่ลงไปใน Prompt เดียวกัน แล้วส่งทั้งก้อนนั้นไปให้โมเดลตัวไหนก็ตามที่ถูกตั้งค่าไว้ในเดือนนั้น

คำตอบเดียว แหล่งข้อมูลสองชนิด กติกาเดียว

เลเยอร์ Knowledge Engineering มองข้อมูลคู่นี้เป็นหน่วยเดียวกัน

มีคำถามที่ต้องใช้ทั้งสองด้านเข้ามา เลเยอร์จะดึงย่อหน้าที่เกี่ยวข้องออกมาจากคลังเอกสาร และรัน Query แบบอ่านอย่างเดียวบนฐานข้อมูลของลูกค้าเอง ณ ที่ที่มันอยู่ โดยไม่คัดลอกแถวข้อมูลไปไว้ที่ไหน จากนั้นจึงประกอบทั้งสองอย่างเข้าเป็นคำตอบเดียว และตรงนี้คือจุดที่เรื่องน่าสนใจเกิดขึ้น

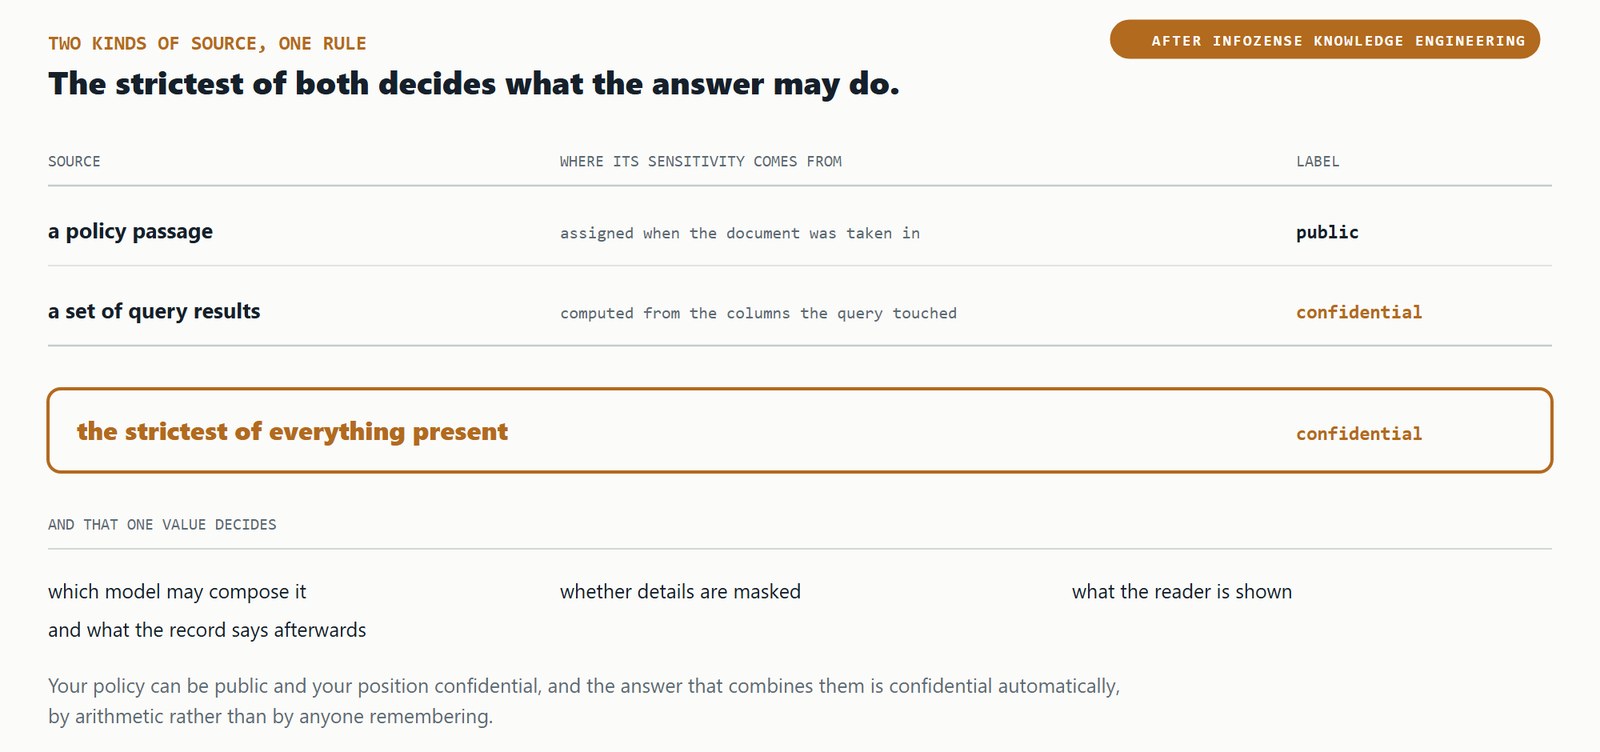
ทุกชิ้นส่วนของคำตอบนั้นเดินทางมาพร้อมระดับความอ่อนไหวของตัวเอง และมาคนละเส้นทางกัน ย่อหน้าจากเอกสารพก Classification ที่ถูกกำหนดตอนนำเอกสารเข้าระบบมาด้วย ส่วนผลลัพธ์ของ Query พกระดับความอ่อนไหวของตารางที่ Query นั้นไปแตะมาจริง สองกลไก สองที่มา คำตอบเดียว

จากนั้นเลเยอร์จะหยิบระดับที่เข้มที่สุดเท่าที่มีอยู่ มาเป็นระดับความอ่อนไหวของคำตอบทั้งก้อน ไม่ใช่ค่าเฉลี่ย ไม่ใช่ค่าของฝั่งเอกสาร แต่คือค่าสูงสุดข้ามแหล่งข้อมูลทั้งสองชนิด

และค่าเดียวนั้นเป็นตัวตัดสินทุกอย่างที่เหลือ ว่าคำตอบนี้ให้โมเดลภายนอกประกอบได้หรือต้องอยู่บนฮาร์ดแวร์ของคุณเอง ว่าข้อมูลส่วนบุคคลจะถูกปิดบังก่อนออกไปหรือไม่ ว่าผู้อ่านจะเห็นป้ายกำกับแบบไหน และว่าบันทึกจะระบุว่าอย่างไรหลังจากนั้น กติกาเดียว ใช้กับสิ่งที่มาจากสองโลก

สิ่งที่ได้มา สรุปเป็นประโยคเดียว

นโยบายของคุณเป็นข้อมูลสาธารณะได้ ยอดคงค้างของคุณเป็นความลับได้ และคำตอบที่รวมสองอย่างนี้เข้าด้วยกันจะถูกถือว่าเป็นความลับโดยอัตโนมัติ ด้วยเกณฑ์ที่สร้างขึ้นมา ไม่ใช่ด้วยการที่ใครสักคนต้องจำได้

นั่นคือประโยคที่ระบบ Retrieval พูดไม่ได้ เพราะมันไม่เคยมีแหล่งข้อมูลที่สองให้ต้องเข้มงวดด้วยตั้งแต่แรก

เมื่อมี Infozense Knowledge Engineering คำถามหนึ่งข้อดึงย่อหน้าจากนโยบายและผลลัพธ์ของ Query มาประกอบเป็นคำตอบเดียว ย่อหน้านั้นพก Classification ที่ได้รับตอนนำเข้าระบบ ส่วนผลลัพธ์พกระดับความอ่อนไหวของตารางที่ไปแตะมา ระดับที่เข้มที่สุดในสองอย่างนี้กลายเป็น Classification ของคำตอบทั้งก้อน และค่าเดียวนั้นเป็นตัวตัดสินปลายทาง การปิดบังข้อมูล ป้ายกำกับ และบันทึก
สองแหล่งข้อมูล สองวิธีพกระดับความอ่อนไหว และค่าเดียวที่เป็นตัวตัดสิน

จุดที่รวมข้อมูลคือจุดที่มีความเสี่ยงสูงที่สุด

ใน Orchestration ทั่วไป Agent หรือโค้ดที่เขียนขึ้น (เรียกว่า Flow) จะดึงข้อมูลจากหลายฐานข้อมูลและหลายเอกสารมารวมกันเอง แล้วส่งให้โมเดลทันที เมื่อการรวมเกิดขึ้นเองแบบนี้ ข้อมูลที่ถูกรวมจึงไม่ได้ผ่าน Gate เมื่อไม่ผ่าน Gate ก็ไม่มีการตรวจ Classification และไม่มีการปิดบังข้อมูล ผลคือแถวข้อมูลที่เป็นความลับไปถึงโมเดลที่ไม่ได้รับอนุญาตให้เห็นได้ การเขียนกฎไว้ใน Prompt ก็ป้องกันเรื่องนี้ไม่ได้ เพราะ Prompt อาจตกหล่นกฎด้าน Governance ไป และไม่มีส่วนใดตรวจว่ากฎนั้นถูกทำตามจริง

Orchestration ทั่วไป
ดึงข้อมูลเองแถวข้อมูลจากฐานข้อมูล และข้อความจากเอกสาร
→
รวมข้อมูลเองในโค้ดของ Agent หรือ Flow เอง
→
โมเดล
ไม่ผ่าน Gate เลย จึงไม่มีการตรวจป้าย ไม่มีการปิดบังข้อมูล และไม่มีบันทึก กฎที่เขียนไว้ใน Prompt อาจตกหล่นไป และไม่มีส่วนใดตรวจว่ากฎนั้นถูกทำตามจริง
ผ่านเลเยอร์
ข้อมูลที่เลเยอร์ดึงมาเอง
Flow ที่รวมแถวข้อมูลเข้ากับเอกสาร
→
Gate เดียวกันสำหรับทั้งสองทาง
  1. ยึดตามป้ายที่เข้มที่สุดในบรรดาชิ้นที่นำมารวม
  2. ตรวจกับเพดาน ถ้าไม่ผ่านก็หยุดที่นี่
  3. ส่งไปเฉพาะปลายทางที่อนุญาต
  4. ปิดบังข้อมูล เมื่อปลายทางเป็นโมเดลภายนอก
  5. บันทึกทุกการเรียกที่ส่งออกไป
→
โมเดล
การรวมข้อมูลนอก Gate เทียบกับการรวมข้อมูลผ่าน Gate

ความเสี่ยงนี้ไม่ได้เกิดครั้งเดียวแล้วจบ ทุกครั้งที่มีการเพิ่ม Flow ใหม่ที่รวมข้อมูล ถ้า Flow นั้นไม่ได้ผ่าน Gate มันก็ส่งข้อมูลให้โมเดลโดยตรงได้อีก และจะไม่มีใครรู้ เพราะไม่มีการบันทึก

ทางออกไม่ใช่การไล่แก้ทีละ Flow แต่คือการเปิดทางให้ Flow เข้ามาผ่าน Gate เดียวกันกับที่ข้อมูลซึ่งเลเยอร์ดึงมาเองต้องผ่าน ข้อมูลที่ Flow รวมขึ้นเองจึงยึดตามป้ายที่เข้มที่สุดในบรรดาชิ้นที่นำมารวม ถูกตรวจกับเพดาน ถูกส่งไปเฉพาะปลายทางที่อนุญาต ถูกปิดบังข้อมูลเมื่อปลายทางเป็นโมเดลภายนอก และถูกบันทึก ในระบบนี้ Flow ที่รวมแถวข้อมูลเข้ากับเอกสารนโยบายทำงานผ่าน Gate นี้แล้ว

ผลิตภัณฑ์ไหนก็ตามที่เคยรวมแหล่งข้อมูลสองอย่างนี้เข้าด้วยกัน ย่อมเคยเจอปัญหานี้ ลองถามดูว่า มีทางไหนไหมที่ Flow ซึ่งสร้างในผลิตภัณฑ์จะไปถึงโมเดลได้โดยไม่ผ่าน Gate

ทำไมไม่ Query ตรงไปที่ฐานข้อมูลเลย

ข้อสงสัยนี้มีเหตุผล ถ้าเชื่อได้ว่าทุกคนที่เข้ามาถามจะแยกแยะเองว่าตัวเองมีสิทธิ์เห็นอะไร และนำอะไรมารวมกันได้บ้าง กฎทั้งหมดในเลเยอร์นี้ก็คงเป็นภาระเกินจำเป็น และคนส่วนใหญ่ก็แยกแยะได้จริง แต่ผู้เรียกใช้ข้อมูลที่ไม่ใช่คน ทั้งแอปพลิเคชันและ AI Agent กำลังเพิ่มขึ้นทุกที และบ่อยขึ้นเรื่อย ๆ ที่ Agent ตัวหนึ่งส่งผลลัพธ์ต่อให้ Agent อีกตัวหนึ่ง

คนจะชั่งน้ำหนักก่อนว่ากำลังจะรวมอะไรเข้าด้วยกัน แต่ Agent ทำตามที่ถูกสั่ง และคำสั่งนั้นอาจมาจากเนื้อหาที่มันอ่านอยู่ เช่น ข้อความที่ถูกแอบใส่ไว้ในเอกสาร ค่าในช่องของตาราง หรือแถวข้อมูลที่ Query ส่งกลับมา โมเดลไม่ใช่ผู้โจมตี แต่มันถูกใช้เป็นเครื่องมือ ถ้ากฎอยู่ภายใน Agent ข้อความที่ Agent กำลังประมวลผลอยู่นั่นเองก็อาจเกลี้ยกล่อมให้มันละเลยกฎนั้นได้ กฎจึงต้องอยู่ในจุดเดียวที่ผู้เรียกใช้ทุกรายต้องผ่าน ซึ่งเป็นจุดที่คำสั่งใด ๆ ที่แฝงมาในข้อมูลเอื้อมไปไม่ถึง

ด้วยเหตุผลเดียวกัน ในเส้นทางที่มี Governance นั้น Agent ไม่เคยถือ Credential ของฐานข้อมูล เลเยอร์ต่างหากที่ถือ ส่วน Agent มีหน้าที่แค่ส่งคำขอ เลเยอร์เป็นผู้ตัดสินว่าคำขอนั้นได้รับอนุญาตให้รันหรือไม่ แล้วจึงรันและบันทึกไว้ และเมื่อเลเยอร์นำผลลัพธ์จากหลายแหล่งมารวมกัน ผลลัพธ์ที่รวมแล้วจะใช้ระดับที่เข้มที่สุดในบรรดาแหล่งเหล่านั้น ทุกคำตอบที่ส่งกลับไปจะพกระดับนั้นติดไปด้วย ขั้นตอนถัดไป ไม่ว่าจะเป็นคนหรือ Agent จึงถูกกำกับด้วยระดับนั้นได้

Gate ทั้งห้าที่ทำหน้าที่นี้มีคำอธิบายอยู่ในบท คุณกำกับ Agent แล้ว แต่ลืมเลเยอร์ข้อมูลที่อยู่ข้างใต้ ส่วนนี้คือเหตุผลว่าทำไม Gate เหล่านั้นต้องอยู่ในเลเยอร์ ไม่ใช่อยู่ใน Agent สิ่งที่เลเยอร์กำกับคือผู้เรียกใช้ที่เป็นซอฟต์แวร์ ส่วนการตัดสินใจและการลงมือทำยังอยู่กับคน และนั่นคือเรื่องของส่วนถัดไป

คนยังอยู่ในวงจรการตัดสินใจตรงไหน และเพราะอะไร

เลเยอร์ที่รวมเอกสารของคุณเข้ากับฐานข้อมูล ไม่ควรเป็นผู้ตัดสินด้วยว่าข้อมูลนั้นหมายถึงอะไร หรือควรทำอะไรต่อ ดังนั้นจึงตั้งใจออกแบบให้การตัดสินใจเหล่านี้อยู่กับคน

ข้อมูลที่มีป้ายกำกับ
ป้ายติดไปกับตัวข้อมูลกำหนดโดยคนที่รับผิดชอบข้อมูลนั้น ไม่ใช่โดยโมเดล
→
คำขอยึดตามป้ายที่เข้มที่สุดเท่าที่มีไม่ใช่ค่าเฉลี่ย ไม่ใช่ชิ้นแรก แต่เป็นป้ายที่เข้มที่สุดในคำขอครั้งนั้น
→
สาธารณะ → โมเดล Frontier บน Cloud
ลับ → โมเดลบนฮาร์ดแวร์ของคุณเอง
อ่อนไหวที่สุด → ไม่ส่งไปที่โมเดลใดเลย
ตัวอย่างการจับคู่ป้ายกับปลายทาง ซึ่งผู้ดูแลระบบตั้งไว้ครั้งเดียว
ข้อมูลที่ไม่มีป้ายกำกับ
ไม่มีป้าย ป้ายที่เลเยอร์ไม่รู้จัก หรือป้ายที่ผิดรูปแบบ
→
ถือเป็นระดับที่อ่อนไหวที่สุด
→
ไปได้แค่ปลายทางที่เข้มงวดที่สุด คือฮาร์ดแวร์ของคุณเอง หรือไม่ส่งไปที่โมเดลใดเลย
เมื่อเปิดการตรวจสอบ ซึ่งคนเป็นผู้ตัดสินใจเปิดเป็นราย Workspace ข้อความใดที่เลเยอร์ตรวจย้อนกลับไปหาย่อหน้าที่มี Classification ในระบบของเลเยอร์เองไม่ได้ จะเข้าสู่เส้นทางที่สองนี้ ไม่ว่าจะมาพร้อมป้ายอะไรก็ตาม
คนเป็นผู้ตัดสินใจ ว่าใครจะติดป้ายให้ข้อมูล จะเปิดการตรวจสอบหรือไม่ และจะทำอะไรกับทุกคำตอบ ส่วนเลเยอร์ไม่เขียนอะไรลงในระบบของคุณ และบันทึกระดับที่แต่ละคำตอบพกไว้
ข้อมูลที่มีและไม่มีป้ายกำกับถูกจัดการอย่างไร และคนตัดสินใจตรงไหน

เลเยอร์อ่าน คนลงมือทำ เลเยอร์รันคำสั่งอ่านอย่างเดียวเพียงหนึ่งคำสั่ง ซึ่งผ่านการตรวจกับรายการที่อนุญาตก่อนรัน ใช้ได้เฉพาะกับตารางที่เจ้าของข้อมูลอนุมัติไว้ และบันทึกไว้ทุกครั้ง มันแก้ไขข้อมูลหรืออัปเดตระบบใด ๆ ไม่ได้ เมื่อคำตอบบอกว่ามีอะไรต้องทำ คนเป็นผู้ทำ ในระบบของตัวเอง ภายใต้อำนาจของตัวเอง

คนเป็นเจ้าของป้ายกำกับ ระดับความอ่อนไหวที่เลเยอร์ยึดตาม ถูกกำหนดโดยคนที่รับผิดชอบข้อมูลนั้น สำหรับเอกสาร กำหนดตอนนำเข้าระบบ สำหรับตาราง กำหนดไว้ในรายการ Catalog ของตารางนั้น หน้าที่ของเลเยอร์ไม่ใช่การตัดสินว่าอะไรเป็นความลับ แต่คือทำให้แน่ใจว่าสิ่งที่คนตัดสินไว้ถูกนำไปใช้ทุกครั้ง รวมถึงตอนที่นำสองแหล่งข้อมูลมาประกอบเป็นคำตอบเดียว

จะเข้มงวดแค่ไหนเป็นการตัดสินใจ และมีบันทึก Workspace หนึ่งสามารถตั้งให้รับเฉพาะสิ่งที่เลเยอร์ตรวจสอบเองได้ ในโหมดนั้น เนื้อหาที่ส่งไปให้โมเดลภายนอกได้ มีเพียงเนื้อหาที่เลเยอร์ดึงมาเองจากเอกสารที่มี Classification แล้ว และพกป้ายกำกับของเอกสารนั้นไปด้วย ส่วนที่เหลือทั้งหมด รวมถึงผลลัพธ์ที่ Query จากฐานข้อมูล จะอยู่บนฮาร์ดแวร์ของคุณเอง นี่คือการยอมสละขีดความสามารถของโมเดลภายนอก เพื่อแลกกับความแน่นอน การแลกนี้เหมาะกับ Workspace หนึ่ง ๆ หรือไม่ เป็นดุลยพินิจของคนที่รับผิดชอบ Workspace นั้น ไม่ใช่ของซอฟต์แวร์ และการเปลี่ยนค่านี้ถูกบันทึกไว้

ถ้าจะคลาดเคลื่อน ให้คลาดเคลื่อนไปทางระมัดระวัง Query ที่ไปแตะตารางที่อ่อนไหว จะพกระดับของตารางนั้นมาด้วย แม้จะเป็นแค่การนับจำนวนแถว คำตอบที่รวมจากหลายส่วนจะใช้ระดับที่เข้มที่สุดในบรรดาส่วนเหล่านั้น บางครั้งคำตอบจึงถูกจัดการอย่างระมัดระวังเกินจำเป็น และนั่นคือทิศทางที่ออกแบบให้เป็น ทุก Query และทุกการเรียกโมเดลถูกบันทึกพร้อมระดับที่มันพกไว้ คนจึงตรวจดูได้เสมอว่าเพราะอะไร
ข้อสรุป

ทุกองค์กรไม่ว่าจะขนาดไหน ก็มีความทรงจำอยู่สองแบบ แบบหนึ่งเก็บสิ่งที่องค์กรตัดสินใจไว้ และมันถูกเขียนไว้ อีกแบบเก็บสิ่งที่เกิดขึ้นจริง และไม่มีใครเขียนมันเลย

คนของคุณ Join สองอย่างนี้อยู่แล้ว พวกเขาทำมันในหัว ทำได้ช้า และเป็นเหตุผลเดียวที่ทำให้สองด้านนี้ได้มาเจอกัน การยกงานนั้นให้ AI ไม่ใช่เรื่องของการเพิ่มประสิทธิภาพ แต่เป็นเรื่องของ Governance เพราะวินาทีที่เครื่องถือข้อมูลครบทั้งสองด้าน มันย่อมรวมสองด้านนั้นเข้าด้วยกันได้ในแบบที่ไม่เคยมีใครตรวจสอบ

และนั่นคือสาระทั้งหมดของชุดบทความนี้ ไม่ใช่ระบบ Retrieval ที่มีนโยบายแปะไว้ แต่คือเลเยอร์ที่ถือความทรงจำทั้งสองแบบไว้พร้อมกันได้ และยังตอบได้ว่ามันทำอะไรกับความทรงจำเหล่านั้นไปบ้าง

คุณไม่ได้สร้างมัน คุณแค่ตั้งค่ามัน

คุณไม่ต้องเขียน Engine สำหรับรวมข้อมูล และไม่ต้องเขียนโค้ดสำหรับ Join Classification เอง Infozense Knowledge Engineering อ่านคลังเอกสารของคุณ และ Query ฐานข้อมูลของคุณ ณ ที่ที่มันอยู่ ประกอบคำตอบจากทั้งสองแหล่ง หยิบระดับความอ่อนไหวที่เข้มที่สุดเท่าที่มีอยู่ข้ามทั้งสองแหล่ง แล้วกำหนดปลายทาง ปิดบังข้อมูล ติดป้ายกำกับ และบันทึก ด้วยค่าเดียวนั้น

คุณกำหนด Classification ให้เอกสารของคุณ และเชื่อมฐานข้อมูลของคุณเข้ามา เลเยอร์เป็นตัวทำให้แน่ใจว่าการรวมสองอย่างนี้เข้าด้วยกัน จะไม่แอบสร้างสิ่งที่ทั้งสองอย่างไม่เคยได้รับอนุญาตให้เป็นขึ้นมา

คนของคุณต้องเปิดสองระบบเพื่อตอบคำถามเดียวอยู่หรือเปล่า?

นี่คือเรื่องที่เราถนัดที่สุด เพียงนำคำถามหนึ่งข้อที่ต้องใช้ทั้งนโยบายและตารางข้อมูลมา แล้วเราจะไล่ดูไปด้วยกันว่าต้องมีอะไรเป็นจริงบ้างจึงจะตอบมันได้อย่างปลอดภัย

คุยกับเรา →